|
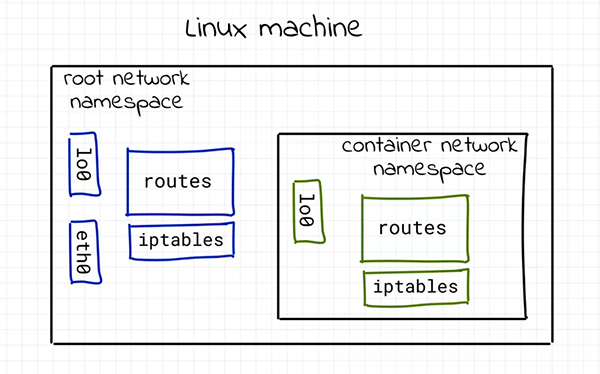
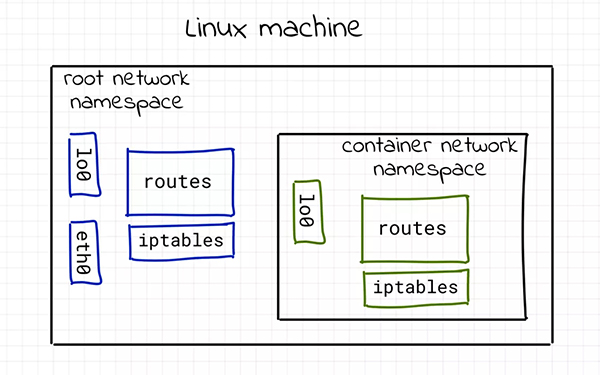
四大博彩公司排名微信h5博彩游戏平台(www.enxzu.com) 乐鱼龙虎斗 使用容器老是嗅觉像使用魔法相似。关于那些领路底层旨趣的东说念主来说容器很好用,然而关于不睬解的东说念主来说即是个恶梦。很侥幸的是,咱们仍是商量容器技能很深入,甚而凯旋揭秘容器只是卤莽并受限的 Linux 进度,运行容器并不需要镜像,以及另一个方面,构建镜像需要运行一些容器。 当今是时候处置容器收罗问题了。或者更准确地说,单主机容器收罗问题。本文会恢复这些问题: 怎样假造化收罗资源,让容器以为我方领有独占收罗? 怎样让容器们和平共处,之间不会相互侵扰,况兼大致互重复信? 舒缓器里面怎样探望外部天下(比如,互联网)? 从外部天下怎样探望某台机器上的容器呢(比如,端口发布)?最终后果很较着,单主机容器收罗是已知的 Linux 功能的肤浅组合: 收罗定名空间(namespace) 假造 Ethernet拓荒(veth) 假造收罗交换机(网桥) IP路由和收罗地址翻译(NAT)况兼不需要任何代码就不错让这么的收罗魔法发生…… 前提条款浪漫 Linux 刊行版都不错。本文的所有例子都是在 vagrant CentOS 8 的假造机上实施的: $ vagrant init centos/8 $ vagrant up $ vagrant ssh [vagrant@localhost ~]$ uname -a Linux localhost.localdomain 4.18.0-147.3.1.el8_1.x86_64 为了肤浅起见,本文使用容器化处置决议(比如,Docker 或者 Podman)。咱们会重心先容基本见地,并使用最肤浅的用具来达到学习方针。 network 定名空间卤莽容器Linux 收罗栈包括哪些部分?昭彰,是一系列收罗拓荒。还有别的吗?可能还包括一系列的路由法式。况兼不要健忘,netfilter hook,包括由iptables法式界说的。 咱们不错快速创建一个并不复杂的剧本 inspect-net-stack.sh: 菠菜平台信誉评级#!/usr/bin/env bash echo "> Network devices" ip link echo -e "\n> Route table" ip route echo -e "\n> Iptables rules" iptables --list-rules 在运行剧本前,让咱们修改下 iptable rule: $ sudo iptables -N ROOT_NS 这之后,在机器上实施上头的剧本,输出如下: $ sudo ./inspect-net-stack.sh > Network devices 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP mode DEFAULT group default qlen 1000 link/ether 52:54:00:e3:27:77 brd ff:ff:ff:ff:ff:ff > Route table default via 10.0.2.2 dev eth0 proto dhcp metric 100 10.0.2.0/24 dev eth0 proto kernel scope link src 10.0.2.15 metric 100 > Iptables rules -P INPUT ACCEPT -P FORWARD ACCEPT -P OUTPUT ACCEPT -N ROOT_NS 咱们对这些输出感兴味,因为要确保行将创建的每个容器都有各自独处的收罗栈。 你可能仍是知说念了,用于容器卤莽的一个 Linux 定名空间是收罗定名空间(network namespace)。从 man ip-netns 不错看到,“收罗定名空间是收罗栈逻辑上的另一个副本,它有我方的路由,防火墙法式和收罗拓荒。”为了简化起见,这是本文使用的独一的定名空间。咱们并莫得创建皆备卤莽的容器,而是将边界截止在收罗栈上。 创建收罗定名空间的一种措施是 ip 用具,它是 iproute2 的一部分: $ sudo ip netns add netns0 $ ip netns netns0 怎样使用刚才创建的定名空间呢?一个很好用的敕令 nsenter。投入一个或多个特定的定名空间,然后实施指定的剧本: $ sudo nsenter --net=/var/run/netns/netns0 bash # 新建的 bash 进度在 netns0 里 $ sudo ./inspect-net-stack.sh > Network devices 1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN mode DEFAULT group default qlen 1000 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 > Route table > Iptables rules -P INPUT ACCEPT -P FORWARD ACCEPT -P OUTPUT ACCEPT 从上头的输出不错显现地看到 bash 进度运行在 netns0 定名空间,这时看到的是皆备不同的收罗栈。这里莫得路由法式,莫得自界说的 iptables chain,惟有一个 loopback 的收罗拓荒。
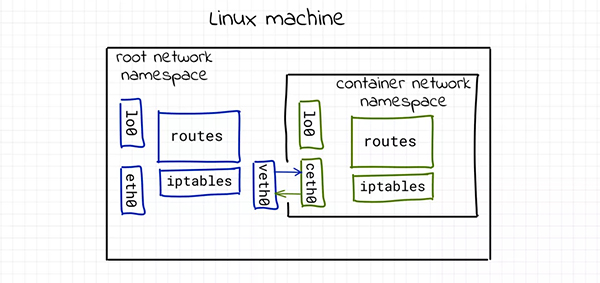
淌若咱们无法和某个专有的收罗栈通讯,那么它看上去就没什么用。侥幸的是,Linux 提供了好用的用具——假造 Ethernet拓荒。从 man veth 不错看到,“veth 拓荒是假造 Ethernet 拓荒。他们不错看成收罗定名空间之间的通说念(tunnel),从而创建团结到另一个定名空间里的物理收罗拓荒的桥梁,然而也不错看成独处的收罗拓荒使用。” 假造 Ethernet 拓荒频繁都成对出现。无须驰念,先看一下创建的剧本: $ sudo ip link add veth0 type veth peer name ceth0 用这条肤浅的敕令,咱们就不错创建一双互联的假造 Ethernet 拓荒。默许聘用了 veth0 和 ceth0 这两个称号。 $ ip link 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP mode DEFAULT group default qlen 1000 link/ether 52:54:00:e3:27:77 brd ff:ff:ff:ff:ff:ff 5: ceth0@veth0: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000 link/ether 66:2d:24:e3:49:3f brd ff:ff:ff:ff:ff:ff 6: veth0@ceth0: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000 link/ether 96:e8:de:1d:22:e0 brd ff:ff:ff:ff:ff:ff 创建的 veth0 和 ceth0 都在主机的收罗栈(也称为 root 收罗定名空间)上。将 netns0 定名空间团结到 root 定名空间,需要将一个拓荒留在 root 定名空间,另一个挪到 netns0 里: $ sudo ip link set ceth0 netns netns0 # 列出所有拓荒,不错看到 ceth0 仍是从 root 栈里褪色了 $ ip link 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP mode DEFAULT group default qlen 1000 link/ether 52:54:00:e3:27:77 brd ff:ff:ff:ff:ff:ff 6: veth0@if5: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000 link/ether 96:e8:de:1d:22:e0 brd ff:ff:ff:ff:ff:ff link-netns netns0 一朝启用拓荒况兼分派了符合的 IP 地址,其中一个拓荒上产生的包会坐窝出当今其配对拓荒里,从而团结起两个定名空间。从 root 定名空间初始: $ sudo ip link set veth0 up $ sudo ip addr add 172.18.0.11/16 dev veth0 然后是 netns0: 
$ sudo nsenter --net=/var/run/netns/netns0 $ ip link set lo up $ ip link set ceth0 up $ ip addr add 172.18.0.10/16 dev ceth0 $ ip link 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 5: ceth0@if6: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP mode DEFAULT group default qlen 1000 link/ether 66:2d:24:e3:49:3f brd ff:ff:ff:ff:ff:ff link-netnsid 0
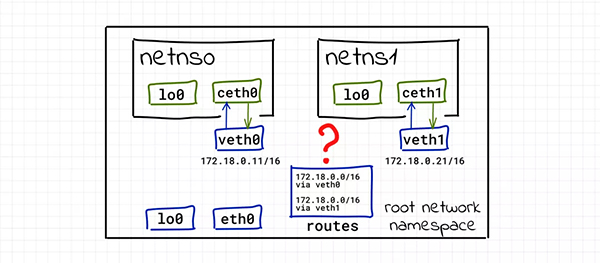
查验连通性: # 在 netns0 里 ping root 的 veth0 $ ping -c 2 172.18.0.11 PING 172.18.0.11 (172.18.0.11) 56(84) bytes of data. 64 bytes from 172.18.0.11: icmp_seq=1 ttl=64 time=0.038 ms 64 bytes from 172.18.0.11: icmp_seq=2 ttl=64 time=0.040 ms --- 172.18.0.11 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 58ms rtt min/avg/max/mdev = 0.038/0.039/0.040/0.001 ms # 离开 netns0 $ exit # 在root定名空间里ping ceth0 $ ping -c 2 172.18.0.10 PING 172.18.0.10 (172.18.0.10) 56(84) bytes of data. 64 bytes from 172.18.0.10: icmp_seq=1 ttl=64 time=0.073 ms 64 bytes from 172.18.0.10: icmp_seq=2 ttl=64 time=0.046 ms --- 172.18.0.10 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 3ms rtt min/avg/max/mdev = 0.046/0.059/0.073/0.015 ms 同期,淌若尝试从 netns0 定名空间探望其他地址,它是不不错凯旋的: # 在 root 定名空间 $ ip addr show dev eth0 2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP group default qlen 1000 link/ether 52:54:00:e3:27:77 brd ff:ff:ff:ff:ff:ff inet 10.0.2.15/24 brd 10.0.2.255 scope global dynamic noprefixroute eth0 valid_lft 84057sec preferred_lft 84057sec inet6 fe80::5054:ff:fee3:2777/64 scope link valid_lft forever preferred_lft forever # 记着这里 IP 是 10.0.2.15 $ sudo nsenter --net=/var/run/netns/netns0 # 尝试ping主机的eth0 $ ping 10.0.2.15 connect: Network is unreachable # 尝试团结外网 $ ping 8.8.8.8 connect: Network is unreachable 这也很好领路。在 netns0 路由内外莫得这类包的路由。独一的 entry 是怎样到达 172.18.0.0/16 收罗: # 在netns0定名空间: $ ip route 172.18.0.0/16 dev ceth0 proto kernel scope link src 172.18.0.10 Linux 有好几种方式教育路由表。其中一种是径直从收罗接口上索要路由。记着,定名空间创建后, netns0 里的路由表是空的。然而随后咱们添加了 ceth0 拓荒况兼分派了IP地址 172.18.0.0/16。因为咱们使用的不是肤浅的 IP 地址,而是地址和子网掩码的组合,收罗栈不错从其中索要长进由信息。方针地是 172.18.0.0/16 的每个收罗包都和会过 ceth0 拓荒。然而其他包会被丢弃。雷同的,root 定名空间也有了个新的路由: # 在root定名空间: $ ip route # ... 忽略无关行 ... 172.18.0.0/16 dev veth0 proto kernel scope link src 172.18.0.11 这里,就不错恢复第一个问题了。咱们了解了怎样卤莽,假造化况兼团结Linux收罗栈。 使用假造收罗 switch(网桥)团结容器容器化念念想的驱能源是高效的资源分享。是以,一台机器上只运行一个容器并不常见。违反,最终方针是尽可能地在分享的环境上运行更多的卤莽进度。因此,淌若按照上述 veth 决议,在归拢台主机上放弃多个容器的话会发生什么呢?让咱们尝试添加第二个容器。 # 从 root 定名空间 $ sudo ip netns add netns1 $ sudo ip link add veth1 type veth peer name ceth1 $ sudo ip link set ceth1 netns netns1 $ sudo ip link set veth1 up $ sudo ip addr add 172.18.0.21/16 dev veth1 $ sudo nsenter --net=/var/run/netns/netns1 $ ip link set lo up $ ip link set ceth1 up $ ip addr add 172.18.0.20/16 dev ceth1 查验连通性: 不过可以肯定的是护肤在表皮这个层面能做的事情还是挺多的,而这其中除了角质层的调理,稍微升级维度的我不得不跟你说说朗格汉斯细胞,这个细胞就驻扎在我们的表皮层,虽然我第一听到这个词是在2014年初代资生堂红腰子的产品中,但其实这个细胞在155年前就被德国的生物科学家发现了,并且也是以发现者的名字来命名了这个细胞,它存在于我们表皮,是肌肤防御力的哨兵,当细菌要穿过表皮,造成更大影响的破坏力的时候,就会被它侦测到,同时它调配和分配肌肤的免疫资源,唤醒吞噬细胞,通知T细胞,联合B细胞。总之肌肤的自我强大而复杂的免疫调节功能,开启的关键一点的根源就是朗格汉斯细胞。 张帅/多勒海德当日6:3拿下首盘,但第二盘被对手以同样比分还以颜色。决胜盘中,张帅/多勒海德虽然在4:1领先的情况下被对手回破施压,但第10局张帅在对手占先、拿到局点的情况下连得3分,皇冠开户6:4确保胜利到手。 # 从 netns1 无法连通 root 定名空间! $ ping -c 2 172.18.0.21 PING 172.18.0.21 (172.18.0.21) 56(84) bytes of data. From 172.18.0.20 icmp_seq=1 Destination Host Unreachable From 172.18.0.20 icmp_seq=2 Destination Host Unreachable --- 172.18.0.21 ping statistics --- 2 packets transmitted, 0 received, +2 errors, 100% packet loss, time 55ms pipe 2 # 然而路由是存在的! $ ip route 172.18.0.0/16 dev ceth1 proto kernel scope link src 172.18.0.20 # 离开 netns1 $ exit # 从 root 定名空间无法连通 netns1 $ ping -c 2 172.18.0.20 PING 172.18.0.20 (172.18.0.20) 56(84) bytes of data. From 172.18.0.11 icmp_seq=1 Destination Host Unreachable From 172.18.0.11 icmp_seq=2 Destination Host Unreachable --- 172.18.0.20 ping statistics --- 2 packets transmitted, 0 received, +2 errors, 100% packet loss, time 23ms pipe 2 # 从netns0不错连通 veth1 $ sudo nsenter --net=/var/run/netns/netns0 $ ping -c 2 172.18.0.21 PING 172.18.0.21 (172.18.0.21) 56(84) bytes of data. 64 bytes from 172.18.0.21: icmp_seq=1 ttl=64 time=0.037 ms 64 bytes from 172.18.0.21: icmp_seq=2 ttl=64 time=0.046 ms --- 172.18.0.21 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 33ms rtt min/avg/max/mdev = 0.037/0.041/0.046/0.007 ms # 然而仍然无法连通 netns1 $ ping -c 2 172.18.0.20 PING 172.18.0.20 (172.18.0.20) 56(84) bytes of data. From 172.18.0.10 icmp_seq=1 Destination Host Unreachable From 172.18.0.10 icmp_seq=2 Destination Host Unreachable --- 172.18.0.20 ping statistics --- 2 packets transmitted, 0 received, +2 errors, 100% packet loss, time 63ms pipe 2 晕!有场合出错了……netns1 有问题。它无法团结到 root,况兼从 root 定名空间里也无法探望到它。然而,因为两个容器都在疏导的 IP 网段 172.18.0.0/16 里,从 netns0 容器不错探望到主机的 veth1。 这里花了些时候来找到原因,不外很较着碰到的是路由问题。先查一下 root 定名空间的路由表: $ ip route # ... 忽略无关行... # 172.18.0.0/16 dev veth0 proto kernel scope link src 172.18.0.11 172.18.0.0/16 dev veth1 proto kernel scope link src 172.18.0.21 在添加了第二个 veth 对之后,root 的收罗栈知说念了新路由 172.18.0.0/16 dev veth1 proto kernel scope link src 172.18.0.21,然而之前仍是存在该收罗的路由了。当第二个容器尝试 ping veth1 时,选中的是第一个路由法式,这导致收罗无法连通。淌若咱们删除第一个路由 sudo ip route delete 172.18.0.0/16 dev veth0 proto kernel scope link src 172.18.0.11,然后再行查验连通性,应该就莫得问题了。netns1 不错连通,然而 netns0 就不行了。
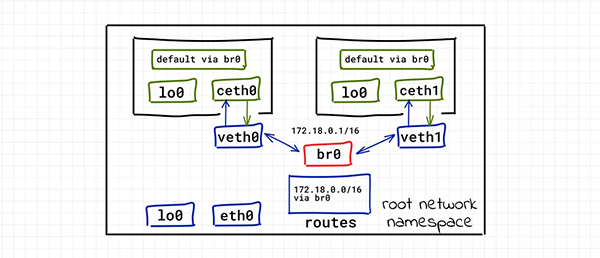
淌若咱们为 netns1 聘用其他的网段,应该就都不错连通。然而,多个容器在归拢个 IP 网段上应该是合理的使用场景。因此,咱们需要退换 veth 决议。 别忘了还有 Linux 网桥——另一种假造化收罗技能!Linux 网桥作用雷同于收罗 switch。它会在团结到其上的接口间转发收罗包。况兼因为它是 switch,它是在 L2 层完成这些转发的。 试试这个用具。然而率先,需要排除已有竖立,因为之前的一些建立当今不再需要了。删除收罗定名空间: $ sudo ip netns delete netns0 $ sudo ip netns delete netns1 $ sudo ip link delete veth0 $ sudo ip link delete ceth0 $ sudo ip link delete veth1 $ sudo ip link delete ceth1 快速重建两个容器。属目,咱们莫得给新的veth0和veth1拓荒分派任何IP地址: $ sudo ip netns add netns0 $ sudo ip link add veth0 type veth peer name ceth0 $ sudo ip link set veth0 up $ sudo ip link set ceth0 netns netns0 $ sudo nsenter --net=/var/run/netns/netns0 $ ip link set lo up $ ip link set ceth0 up $ ip addr add 172.18.0.10/16 dev ceth0 $ exit $ sudo ip netns add netns1 $ sudo ip link add veth1 type veth peer name ceth1 $ sudo ip link set veth1 up $ sudo ip link set ceth1 netns netns1 $ sudo nsenter --net=/var/run/netns/netns1 $ ip link set lo up $ ip link set ceth1 up $ ip addr add 172.18.0.20/16 dev ceth1 $ exit 确保主机上莫得新的路由: $ ip route default via 10.0.2.2 dev eth0 proto dhcp metric 100 10.0.2.0/24 dev eth0 proto kernel scope link src 10.0.2.15 metric 100 临了创建网桥接口: $ sudo ip link add br0 type bridge $ sudo ip link set br0 up 将veth0和veth1接到网桥上: $ sudo ip link set veth0 master br0 $ sudo ip link set veth1 master br0
查验容器间的连通性: $ sudo nsenter --net=/var/run/netns/netns0 $ ping -c 2 172.18.0.20 PING 172.18.0.20 (172.18.0.20) 56(84) bytes of data. 64 bytes from 172.18.0.20: icmp_seq=1 ttl=64 time=0.259 ms 64 bytes from 172.18.0.20: icmp_seq=2 ttl=64 time=0.051 ms --- 172.18.0.20 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 2ms rtt min/avg/max/mdev = 0.051/0.155/0.259/0.104 ms $ sudo nsenter --net=/var/run/netns/netns1 $ ping -c 2 172.18.0.10 PING 172.18.0.10 (172.18.0.10) 56(84) bytes of data. 64 bytes from 172.18.0.10: icmp_seq=1 ttl=64 time=0.037 ms 64 bytes from 172.18.0.10: icmp_seq=2 ttl=64 time=0.089 ms --- 172.18.0.10 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 36ms rtt min/avg/max/mdev = 0.037/0.063/0.089/0.026 ms 太好了!责任得很好。用这种新决议,咱们压根不需要建立 veth0 和 veth1。只需要在 ceth0 和 ceth1 端点分派两个 IP 地址。然而因为它们都团结在疏导的 Ethernet上(记着,它们团结到假造 switch上),之间在 L2 层是连通的: $ sudo nsenter --net=/var/run/netns/netns0 $ ip neigh 172.18.0.20 dev ceth0 lladdr 6e:9c:ae:02:60:de STALE $ exit $ sudo nsenter --net=/var/run/netns/netns1 $ ip neigh 172.18.0.10 dev ceth1 lladdr 66:f3:8c:75:09:29 STALE $ exit 太好了,咱们学习了怎样将容器酿成友邻,让它们互不侵扰,然而又不错连通。 团结外部天下( IP 路由和地址伪装(masquerading))容器间不错通讯。然而它们能和主机,比如root定名空间,通讯吗? $ sudo nsenter --net=/var/run/netns/netns0 $ ping 10.0.2.15 # eth0 address connect: Network is unreachable 这里很较着,netns0 莫得路由: $ ip route 172.18.0.0/16 dev ceth0 proto kernel scope link src 172.18.0.10 root 定名空间不可和容器通讯: # 率先使用 exit 离开netns0: $ ping -c 2 172.18.0.10 PING 172.18.0.10 (172.18.0.10) 56(84) bytes of data. From 213.51.1.123 icmp_seq=1 Destination Net Unreachable From 213.51.1.123 icmp_seq=2 Destination Net Unreachable --- 172.18.0.10 ping statistics --- 2 packets transmitted, 0 received, +2 errors, 100% packet loss, time 3ms $ ping -c 2 172.18.0.20 PING 172.18.0.20 (172.18.0.20) 56(84) bytes of data. From 213.51.1.123 icmp_seq=1 Destination Net Unreachable From 213.51.1.123 icmp_seq=2 Destination Net Unreachable --- 172.18.0.20 ping statistics --- 2 packets transmitted, 0 received, +2 errors, 100% packet loss, time 3ms 要教育 root 和容器定名空间的连通性,咱们需要给网桥收罗接口分派 IP 地址: $ sudo ip addr add 172.18.0.1/16 dev br0 一朝给网桥收罗接口分派了 IP 地址,在主机的路由内外就会多一条路由: $ ip route # ...忽略无关行 ... 172.18.0.0/16 dev br0 proto kernel scope link src 172.18.0.1 $ ping -c 2 172.18.0.10 PING 172.18.0.10 (172.18.0.10) 56(84) bytes of data. 64 bytes from 172.18.0.10: icmp_seq=1 ttl=64 time=0.036 ms 64 bytes from 172.18.0.10: icmp_seq=2 ttl=64 time=0.049 ms --- 172.18.0.10 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 11ms rtt min/avg/max/mdev = 0.036/0.042/0.049/0.009 ms $ ping -c 2 172.18.0.20 PING 172.18.0.20 (172.18.0.20) 56(84) bytes of data. 64 bytes from 172.18.0.20: icmp_seq=1 ttl=64 time=0.059 ms 64 bytes from 172.18.0.20: icmp_seq=2 ttl=64 time=0.056 ms --- 172.18.0.20 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 4ms rtt min/avg/max/mdev = 0.056/0.057/0.059/0.007 ms 容器可能也不错 ping 网桥接口,然而它们照旧无法团结到主机的 eth0。需要为容器添加默许的路由: $ sudo nsenter --net=/var/run/netns/netns0 $ ip route add default via 172.18.0.1 $ ping -c 2 10.0.2.15 PING 10.0.2.15 (10.0.2.15) 56(84) bytes of data. 64 bytes from 10.0.2.15: icmp_seq=1 ttl=64 time=0.036 ms 64 bytes from 10.0.2.15: icmp_seq=2 ttl=64 time=0.053 ms --- 10.0.2.15 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 14ms rtt min/avg/max/mdev = 0.036/0.044/0.053/0.010 ms # 为`netns1`也作念上述建立 这个转换基本上把主机酿成了路由,况兼网桥接口酿成了容器间的默许网关。
很好,咱们将容器团结到 root 定名空间上。当今,持续尝试将它们团结到外部天下。Linux 上默许 disable 了收罗包转发(比如,路由功能)。咱们需要先启用这个功能: 皇冠体育皇冠hg86a皇冠体育源码# 在 root 定名空间 sudo bash -c 'echo 1 > /proc/sys/net/ipv4/ip_forward' 再次查验连通性: 体育博彩软件排行榜$ sudo nsenter --net=/var/run/netns/netns0 $ ping 8.8.8.8 # hung住了... 照旧不责任。那儿弄错了呢?淌若容器不错向外部发包,那么方针业绩器无法将包发还容器,因为容器的IP地址是稀奇的,阿谁特定 IP 的路由法式惟有腹地收罗知说念。况兼有许多容器分享的是皆备疏导的稀奇IP地址 172.18.0.10。这个问题的处置措施称为收罗地址翻译(NAT)。在到达外部收罗之前,容器发出的包会将源IP地址替换为主机的外部收罗地址。主机还会追踪所有已有的映射,会在将包转发还容器之前还原之前被替换的 IP 地址。听上去很复杂,然而有一个好音信!iptables 模块让咱们只需要一条敕令就不错完成这一切: 皇冠客服飞机:@seo3687$ sudo iptables -t nat -A POSTROUTING -s 172.18.0.0/16 ! -o br0 -j MASQUERADE 敕令高出肤浅。在 nat 内外添加了一条 POSTROUTING chain 的新路由,会替换伪装所有源于 172.18.0.0/16 收罗的包,然而欠亨过网桥接口。 查验连通性: $ sudo nsenter --net=/var/run/netns/netns0 $ ping -c 2 8.8.8.8 PING 8.8.8.8 (8.8.8.8) 56(84) bytes of data. 64 bytes from 8.8.8.8: icmp_seq=1 ttl=61 time=43.2 ms 64 bytes from 8.8.8.8: icmp_seq=2 ttl=61 time=36.8 ms --- 8.8.8.8 ping statistics --- 2 packets transmitted, 2 received, 0% packet loss, time 2ms rtt min/avg/max/mdev = 36.815/40.008/43.202/3.199 ms 要知说念这里咱们用的默许政策——允许所有流量,这在信得过的环境里狠恶常危急的。主机的默许 iptables 政策是ACCEPT: sudo iptables -S -P INPUT ACCEPT -P FORWARD ACCEPT -P OUTPUT ACCEPT Docker 默许截止所有流量,随后只是为已知的旅途启用路由。 如下是在 CentOS 8 机器上,单个容器浮现了端口 5005 时,由 Docker daemon 生成的法式: $ sudo iptables -t filter --list-rules -P INPUT ACCEPT -P FORWARD DROP -P OUTPUT ACCEPT -N DOCKER -N DOCKER-ISOLATION-STAGE-1 -N DOCKER-ISOLATION-STAGE-2 -N DOCKER-USER -A FORWARD -j DOCKER-USER -A FORWARD -j DOCKER-ISOLATION-STAGE-1 -A FORWARD -o docker0 -m conntrack --ctstate RELATED,ESTABLISHED -j ACCEPT -A FORWARD -o docker0 -j DOCKER -A FORWARD -i docker0 ! -o docker0 -j ACCEPT -A FORWARD -i docker0 -o docker0 -j ACCEPT -A DOCKER -d 172.17.0.2/32 ! -i docker0 -o docker0 -p tcp -m tcp --dport 5000 -j ACCEPT -A DOCKER-ISOLATION-STAGE-1 -i docker0 ! -o docker0 -j DOCKER-ISOLATION-STAGE-2 -A DOCKER-ISOLATION-STAGE-1 -j RETURN -A DOCKER-ISOLATION-STAGE-2 -o docker0 -j DROP -A DOCKER-ISOLATION-STAGE-2 -j RETURN -A DOCKER-USER -j RETURN $ sudo iptables -t nat --list-rules -P PREROUTING ACCEPT -P INPUT ACCEPT -P POSTROUTING ACCEPT -P OUTPUT ACCEPT -N DOCKER -A PREROUTING -m addrtype --dst-type LOCAL -j DOCKER -A POSTROUTING -s 172.17.0.0/16 ! -o docker0 -j MASQUERADE -A POSTROUTING -s 172.17.0.2/32 -d 172.17.0.2/32 -p tcp -m tcp --dport 5000 -j MASQUERADE -A OUTPUT ! -d 127.0.0.0/8 -m addrtype --dst-type LOCAL -j DOCKER -A DOCKER -i docker0 -j RETURN -A DOCKER ! -i docker0 -p tcp -m tcp --dport 5005 -j DNAT --to-destination 172.17.0.2:5000 $ sudo iptables -t mangle --list-rules -P PREROUTING ACCEPT -P INPUT ACCEPT -P FORWARD ACCEPT -P OUTPUT ACCEPT -P POSTROUTING ACCEPT $ sudo iptables -t raw --list-rules -P PREROUTING ACCEPT -P OUTPUT ACCEPT让外部天下不错探望容器(端口发布) 人人都知说念不错将容器端口发布给一些(或者所有)主机的接口。然而端口发布到底是什么好奇呢? 假定容器内运行着业绩器: $ sudo nsenter --net=/var/run/netns/netns0 $ python3 -m http.server --bind 172.18.0.10 5000 淌若咱们试着从主机上发送一个HTTP肯求到这个业绩器,一切都责任得很好(root定名空间和所有容器接口之间有结合,虽然不错团结凯旋): 皇冠足球 app# 从 root 定名空间 $ curl 172.18.0.10:5000 <!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/strict.dtd"> # ... 忽略无关行 ... 然而,淌若要从外部探望这个业绩器,应该使用哪个IP呢?咱们知说念的独一 IP 是主机的外部接口地址 eth0: $ curl 10.0.2.15:5000 curl: (7) Failed to connect to 10.0.2.15 port 5000: Connection refused 因此,咱们需要找到措施,大致将到达主机 eth0 5000端口的所有包转发到方针地 172.18.0.10:5000。又是i ptables来襄理! # 外部流量 sudo iptables -t nat -A PREROUTING -d 10.0.2.15 -p tcp -m tcp --dport 5000 -j DNAT --to-destination 172.18.0.10:5000 # 腹地流量 (因为它莫得通过 PREROUTING chain) sudo iptables -t nat -A OUTPUT -d 10.0.2.15 -p tcp -m tcp --dport 5000 -j DNAT --to-destination 172.18.0.10:5000 另外,需要让iptables大致在桥罗致罗上截获流量: sudo modprobe br_netfilter 测试: curl 10.0.2.15:5000 <!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/strict.dtd"> # ... 忽略无关行 ...领路 Docker 收罗驱动 咱们不错何如使用这些学问呢?比如,不错试着领路 Docke r收罗模式[1]。 从 --network host 模式初始。试着比拟一下敕令 ip link 和 sudo docker run -it --rm --network host alpine ip link 的输出。它们果然相似!在 host 模式下,Docker 肤浅地莫得使用收罗定名空间卤莽,容器就在 root 收罗定名空间里责任,况兼和主机分享收罗栈。 近日,一位名为XXX博彩高手一次赌博中以惊人表现夺得,并引起整个博彩界热议和关注。下一个模式是--network none。sudo docker run -it --rm --network host alpine ip link 的输出惟有一个 loopback 收罗接口。这和之前创建的收罗定名空间,莫得添加 veth 拓荒前很相似。 临了是 --network bridge(默许)模式。这恰是咱们前文尝试创建的模式。人人不错试试ip 和iptables敕令,折柳从主机和容器的角度不雅察一下收罗栈。 rootless 容器和收罗Podman 容器管制器的一个很好的特质是缓和于 rootless 容器。然而,你可能属目到,本文使用了许多 sudo 敕令。施展,莫得 root 权限无法建立收罗。Podman 在 root 收罗上的决议[2] 和Docker高出相似。然而在 rootless 容器上,Podman 使用了 slirp4netns[3] 花式: 从 Linux 3.8 初始,非特权用户不错创建 user_namespaces(7) 的同期创建 network_namespaces(7)。然而,非特权收罗定名空间并不是很有效,因为在主机和收罗定名空间之间创建 veth(4) 仍然需要root权限 四大博彩公司排名slirp4netns 不错用皆备非特权的方式将收罗定名空间团结到 Internet 上,通过收罗定名空间里的一个TAP拓荒团结到用户态的TCP/IP栈(slirp)。 www.enxzu.comrootless 收罗是很有限的:“从技能上说,容器自身莫得 IP 地址,因为莫得 root 权限,无法达成收罗拓荒的研究。另外,从 rootless 容器 ping 是不会责任的,因为它短少 CAP_NET_RAW 安全才气,而这是 ping 敕令必需的。”然而它仍然比皆备莫得团结要好。 论断本文先容的组织容器收罗的决议只是是可能决议的一种(可能是最为无为使用的一种)。还有许多别的方式,由官方或者第三方插件达成,然而所有这些决议都严重依赖于 Linux 收罗假造化技能[4]。因此,容器化不错以为是一种假造化技能。
|